L’expérimentation n’est plus le principal défi de l’IA générative en entreprise. Le véritable enjeu est désormais de transformer un POC prometteur en une solution fiable, sécurisée, mesurable et exploitable à l’échelle.
Entre le prototype et la production apparaissent des questions rarement visibles lors des premières expérimentations : comment évaluer la qualité d’un modèle ? Quelle architecture adopter ? Où placer les garde-fous ? Comment maîtriser les coûts d’inférence ? Quels risques doivent conditionner ou empêcher un déploiement ?
Passer du POC à la production nécessite donc moins d’expérimenter davantage que de structurer correctement le projet.
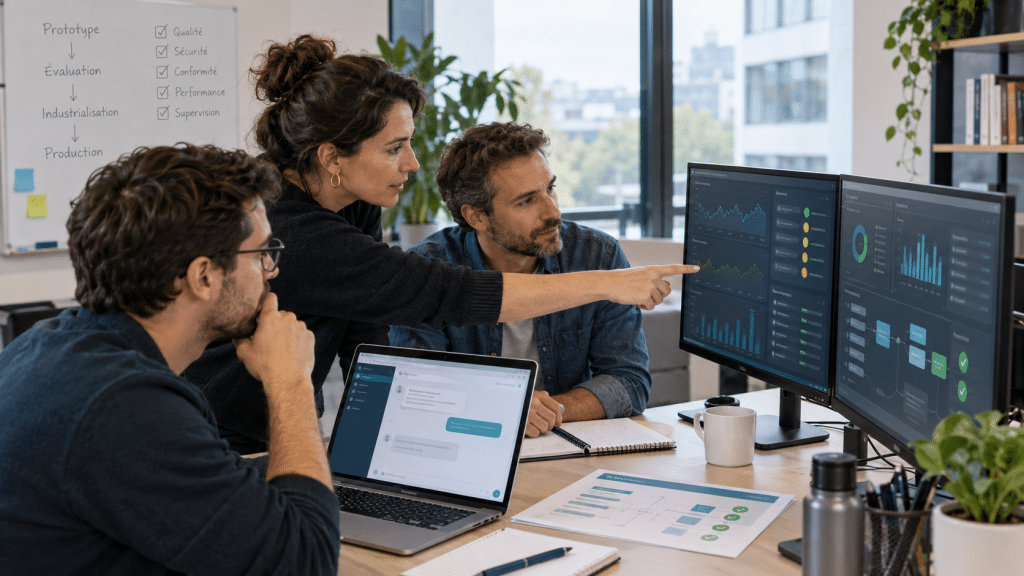
Pourquoi tant de projets restent bloqués avant la production
Un projet d’IA générative diffère fondamentalement d’un projet de Machine Learning classique. Dans les projets de Machine Learning traditionnels, la qualité et la préparation des données occupent généralement une place déterminante dans la réussite du modèle. Avec les foundation models, une partie de cette logique se déplace : on part d’un modèle généraliste déjà entraîné pour l’adapter à un besoin métier, via prompting, RAG, fine-tuning ou orchestration agentique.
Cela ne signifie pas une dépendance moindre aux données, mais une dépendance différente. Un RAG sérieux, du fine-tuning ou une architecture agentique peuvent être tout aussi exigeants en données internes de qualité qu’un projet de Machine Learning classique. Ce qui change, c’est la nature du risque : le modèle reste probabiliste et non déterministe, exposé aux hallucinations, aux risques de confidentialité et aux attaques par prompt, quelle que soit la qualité des données mobilisées en amont.
Quels sont les piliers d’un projet d’IA générative industrialisable ?
Le passage du POC à la production repose sur quatre dimensions complémentaires. Une faiblesse sur l’une d’entre elles peut suffire à empêcher le passage à l’échelle.
- Le cadrage, pour définir le cas d’usage, la valeur attendue et les critères d’évaluation avant tout choix technique : quel critère de succès mesurable, quel budget par million de tokens, quelle latence tolérable, quels risques déjà identifiés.
- L’architecture, pour faire évoluer progressivement la solution du simple appel à un LLM vers des dispositifs intégrant RAG, garde-fous, cache, routage ou orchestration agentique, selon le niveau de maturité réellement nécessaire au cas d’usage.
- L’industrialisation, pour intégrer sécurité, CI/CD, monitoring, observabilité, performance et maîtrise des coûts, avec les mêmes standards que n’importe quel déploiement logiciel en production.
- La gouvernance, pour cartographier les risques, définir les responsabilités et maintenir un niveau de contrôle humain adapté à la criticité de chaque cas d’usage.
Principe Meritis : définir l’évaluation avant de construire
Dans un projet d’IA générative, l’évaluation ne devrait pas intervenir à la fin du POC pour valider ce qui a été construit. Elle doit être définie dès le cadrage.
Elle fixe le comportement attendu de la solution selon quatre dimensions : la capacité métier (le modèle répond-il correctement sur le domaine visé), la qualité de génération (fluidité, cohérence, absence d’hallucinations), le respect des instructions (format, ton, contraintes), et le couple coût/latence.
Ces critères, posés en amont, deviennent ensuite directement les métriques de monitoring en production. Un modèle performant à l’évaluation doit l’être en conditions réelles, et les écarts observés en production réalimentent le cycle d’évaluation.
Un exemple concret : le cadrage d’un système de tri de CV en RH
Sur un cas d’usage de tri et présélection de CV, un risque de biais algorithmique (favoriser ou exclure certains profils selon le genre, l’âge ou l’origine) a été identifié et classé au niveau de criticité le plus élevé de l’échelle utilisée.
Traité en amont du déploiement plutôt que découvert après un incident, ce risque a donné lieu à des mesures concrètes : audit de biais régulier, validation humaine obligatoire avant toute décision, documentation complète, et comité éthique consulté avant mise en production.
C’est la différence entre un risque géré dans l’urgence, avec les conséquences réputationnelles et légales que cela implique, et un risque anticipé dès le cadrage, avec un plan de traitement déjà en place au moment du déploiement.
Aller plus loin : le référentiel Meritis pour opérationnaliser l’IA générative
Le livre blanc « L’opérationnalisation de l’IA avec les foundation models« , réalisé par Edurne Inza, Architecte Data et Auditrice SI au sein du Groupe Meritis, propose un cadre concret pour passer de l’expérimentation à une IA industrialisée et gouvernée.
Vous y trouverez notamment :
- les 7 phases d’opérationnalisation, avec objectifs et livrables associés pour chacune, de la vision stratégique jusqu’au scale
- les 6 niveaux de maturité d’une architecture IA, du LLM-as-a-Service à l’architecture agentique, avec leurs cas d’usage typiques
- une grille d’évaluation des modèles intégrant qualité, factualité, coût et latence, avec des seuils d’exigence chiffrés
- une matrice de criticité des risques IA et sa méthode de traitement en 4 étapes
- le cas d’usage RH complet, avec l’ensemble des risques identifiés et les actions de gouvernance associées
- les principes de monitoring et d’observabilité à mettre en place après la mise en production
Un référentiel conçu pour challenger un projet existant, structurer une feuille de route ou sécuriser le passage d’un POC à la production.
Pour aller plus loin sur le sujet
- Quelle architecture data choisir pour votre entreprise ? : pilotage, stratégie data et choix d’architecture pour une IA scalable.
- Projet IA : les conditions de réussite, du cadrage à la production : gouvernance, données, organisation et mise à l’échelle, par 5 experts Meritis
- OpenRAG, le benchmark open source pour les RAG : comparer les architectures RAG pour industrialiser ses cas d’usage
- Notre savoir-faire Data & IA : cadrage de cas d’usage, gouvernance, architectures, passage du PoC à la production
Questions fréquentes
Le passage d’un POC d’IA générative à la production nécessite de définir des critères d’évaluation mesurables, de choisir une architecture adaptée au besoin réel, d’intégrer les garde-fous nécessaires, d’industrialiser le déploiement selon les standards du software engineering, puis de mettre en place monitoring et gouvernance. Meritis structure cette démarche en 7 phases allant de la vision stratégique au passage à l’échelle.
Un foundation model est un modèle d’IA de très grande taille, entraîné sur des corpus massifs et hétérogènes, capable d’être adapté à des usages multiples (texte, image, audio, données structurées) sans réentraînement complet, via prompting, RAG ou fine-tuning.
Le choix dépend du niveau de risque et de complexité du cas d’usage. Un simple appel au LLM suffit pour prototyper. Un RAG devient nécessaire dès qu’il faut ancrer les réponses sur des données internes. Des garde-fous s’imposent dès que l’application est exposée à des utilisateurs réels. Le cache réduit coûts et latence à volumétrie élevée. Le routage et la gateway apportent une gouvernance centralisée multi-modèles. L’architecture agentique répond aux workflows complexes nécessitant plusieurs agents spécialisés.
Le RAG permet d’incorporer des données internes au moment de la requête et de limiter les hallucinations, sans modifier le modèle. Le fine-tuning répond à des besoins plus spécifiques, comme adapter le ton, le style ou une taxonomie métier particulière. Les deux approches sont complémentaires et non exclusives.
L’évaluation doit être définie dès le cadrage, selon quatre dimensions : la capacité métier du modèle sur le domaine visé, la qualité de génération (cohérence, factualité, absence d’hallucinations), le respect des instructions et du format demandé, et le couple coût/latence. Ces critères servent ensuite de métriques de monitoring en production.
Les garde-fous s’appliquent aux entrées, pour empêcher la fuite d’informations sensibles et les attaques par prompt, et aux sorties, pour détecter les erreurs de formatage, les réponses factuellement fausses et le contenu non conforme. Un système trop strict génère cependant des faux positifs qui bloquent des requêtes légitimes : l’enjeu est de trouver le bon équilibre.
Cela dépend de la volumétrie d’usage, des exigences de confidentialité et du niveau de personnalisation recherché. Une API SaaS offre une mise en place immédiate et l’accès aux meilleurs modèles, avec une facturation à l’usage qui croît avec l’échelle. Le self-hosting demande plus d’ingénierie initiale mais devient rentable à forte volumétrie et répond à des exigences de confidentialité strictes.
Pas encore de commentaires